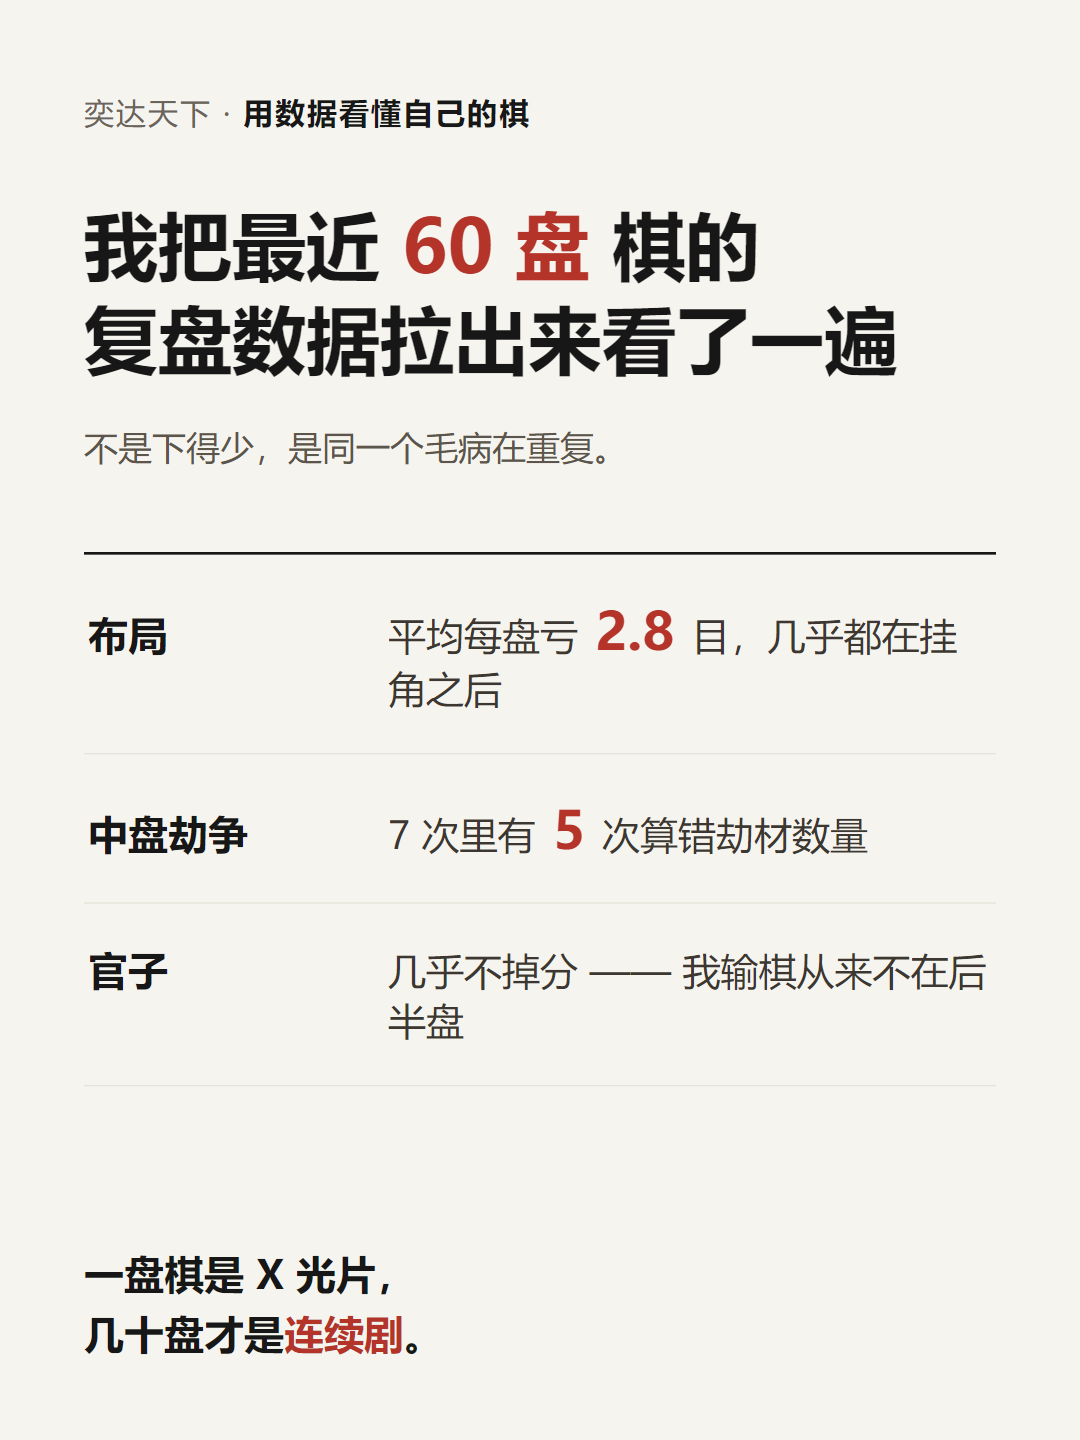
先给一个定义:什么叫“围棋的数字底座”?
让每一盘真实对局,在不需要人工介入的情况下变成结构化、可长期累积、可被机器计算的数据——并且这些数据属于棋手本人。
这句话里有三个词,缺一个都不叫底座。
第一是“自动”。过去围棋的数据全靠人:下完棋抄谱、事后录入、自己保存。数据质量取决于抄谱的人,大多数棋局下完就消失了。现在,棋盘自己记时、自己读秒、自己数子、自己记谱,断网先存在棋盘里、联网自动补齐——数据第一次可以不依赖人工就产生。
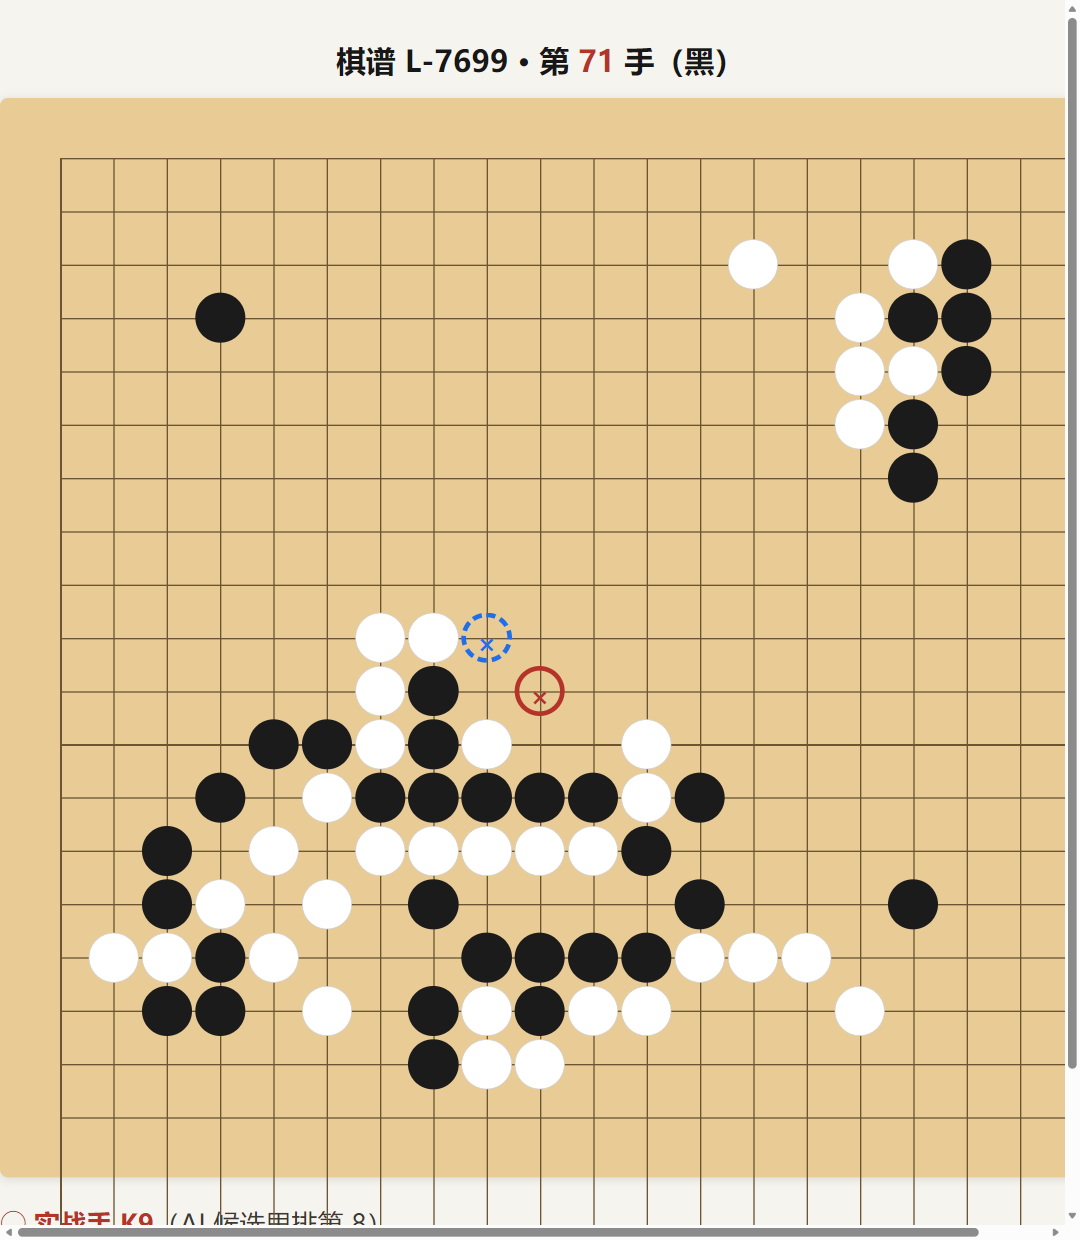
第二是“结构化”。一份 SGF 文件只是一串坐标;而底座的记录里,每一手都带着上下文:轮谁下、用了多少时间、处在布局还是官子、当时的局面复杂度、AI 认为的最优手、以及人类棋手在同等水平下会下这一手的概率。这样的记录才是能被计算的东西——同样是“第 71 手是 K9”,前者只能看,后者能算。
第三是“同一份”。复盘、定段、错题、教学管理、赛事编排,如果各自维护一套数据,那就只是五个工具;当它们跑在同一份数据上,数据就不再是一次性用品,而是会随着棋手一起长大的资产。
说到底:过去的棋谱库是“存起来”的文本,今天的数据底座是“能算”的记录。这是两件事。
为什么说这是一个分水岭
判断一件事是不是分水岭,不看它多热闹,看它改变了什么前提。
围棋过去几十年的所有教学、训练、评价方法,都建立在一个前提上:数据要人来做。因为要人来做,数据必然少、必然迟到、必然不完整。于是“凭印象”不是教练的懒惰,而是在这个前提下的理性选择——他手里除了眼前这盘棋,确实什么都没有。
数字底座改变的正是这个前提。当数据不需要人做、且带上下文地积累下来,整个行业的方法论才有条件重写:教练仍然讲判断、讲心态、讲经验,但他手里第一次有了可查的证据;棋校第一次能从“教了多少课时”转向“孩子到底改掉了什么毛病”;家长第一次能看见“进步”这两个字背后的具体数字。
这不是又一次产品迭代,而是前提变化。前提变化的地方,行业迟早会重排一次。
它已经能看出人看不出来的东西
举一个我们自己系统里跑出来的真实例子——1016 手逐手复盘数据。
第一组数字:把每一手棋按“AI 认为的最优手”与“人类模型认为同水平棋手会下的概率”对照,结果是 AI 认为最好的那些手,人类模型给的概率高达 42.7%;而胜率损失最大的那些手,人类模型只给 7.9%。也就是说:高手的选择是“人性”的,真正把局面下崩的,往往是那些“不像人会下”的手。
第二组数字,按阶段拆开:
- 布局:237 手,单手平均胜率损失 1.9%,其中单手损失 ≥20% 的占 3.4%
- 中盘:553 手,单手平均胜率损失 2.1%,单手损失 ≥20% 的占 3.4%
- 官子:226 手,单手平均胜率损失 4.5%,单手损失 ≥20% 的占 8.0%
官子的失误密度,是布局和中盘的两倍以上。
这两条结论都不在绝大多数棋友和教练的直觉里——大家默认“输棋输在中盘战斗”“官子差不多就行”。没有数据底座,这类结论不可能被看见,因为它需要“大量带上下文的真实对局”这一前提。
行业会怎么变
- 教学:从“多下就好了”到“定位短板”。下得多,只是把同一个直觉偏误重复更多遍;有数据之后,训练的第一步是先找出偏误在哪一类局面上,再集中修。棋校之间的竞争,会从师资话术转向数据能力
- 赛事:从人工流程到信息化闭环。赛事是数据的重要入口,比赛越多,底座上的数据越厚——所以这套赛事系统我们选择免费开放
- 评价:段位之外,会出现“能力画像”。段位回答“你有多强”,画像回答“你强在哪、弱在哪、下一步该练什么”
- 资产:十年之后,中国会不会有自己的围棋成长数据库?这不该是某一家公司的私产,而是协会、棋院、棋校可以共同使用的基础设施
边界,以及一个呼吁
必须说清楚边界。第一,底座的样本还很小(本文说的就是 1016 手),现在只是开始,离“行业基础设施”还有很长的路。第二,数据不替代教练,也不替代棋感——教练的判断、示范、把学生情绪稳住的能力,数据做不了;数据负责让教练的每一句话有依据。
第三,也是最重要的:底座要成为底座,不能靠一家公司。它需要棋校愿意把教学过程数据化,需要赛事主办方愿意让数据回流,需要协会推动数据标准,也需要从业者对“数据会不会让围棋变得无趣”这类问题保持讨论。我们愿意做的,是把赛事系统免费开放、把接口开放出来,先把路修出来。
围棋四千年,绝大部分时间没有数据。今天开始有了。接下来的变化,不在于 AI 有多强,而在于这个行业愿意拿数据做什么。